한 줄 요약
머신러닝(machine learning)은 사람이 규칙을 하나하나 적지 않아도 컴퓨터가 데이터에서 규칙을 찾아내게 하는 방법이에요. 이렇게 찾은 규칙을 담은 것을 ‘모델’이라고 불러요.
학습 목표
- 머신러닝의 4단계(데이터 나누기 → 모델 훈련 → 처음 보는 문제로 시험 → 실제로 쓰기)를 설명할 수 있어요.
- 훈련용 데이터와 시험용 데이터를 나누는 까닭을 말할 수 있어요.
- 과적합의 뜻과 AI·머신러닝·딥러닝의 관계를 알 수 있어요.
생활 속 비유: 짝꿍 글씨체 알아보기
짝꿍 공책에 이름이 없어도 글씨만 보고 “이건 짝꿍 글씨야!” 하고 알아본 적 있지요? 그런데 어떻게 아는지 규칙으로 설명해 보라고 하면 어려워요. 글씨를 많이 보면서 저절로 익혔기 때문이에요. 머신러닝도 비슷해요. 스팸 문자를 거르는 규칙을 사람이 다 적기는 어렵지만, ‘스팸’과 ‘정상’ 표시가 붙은 문자를 아주 많이 보여 주면 컴퓨터가 스스로 규칙을 찾아요.
인포그래픽
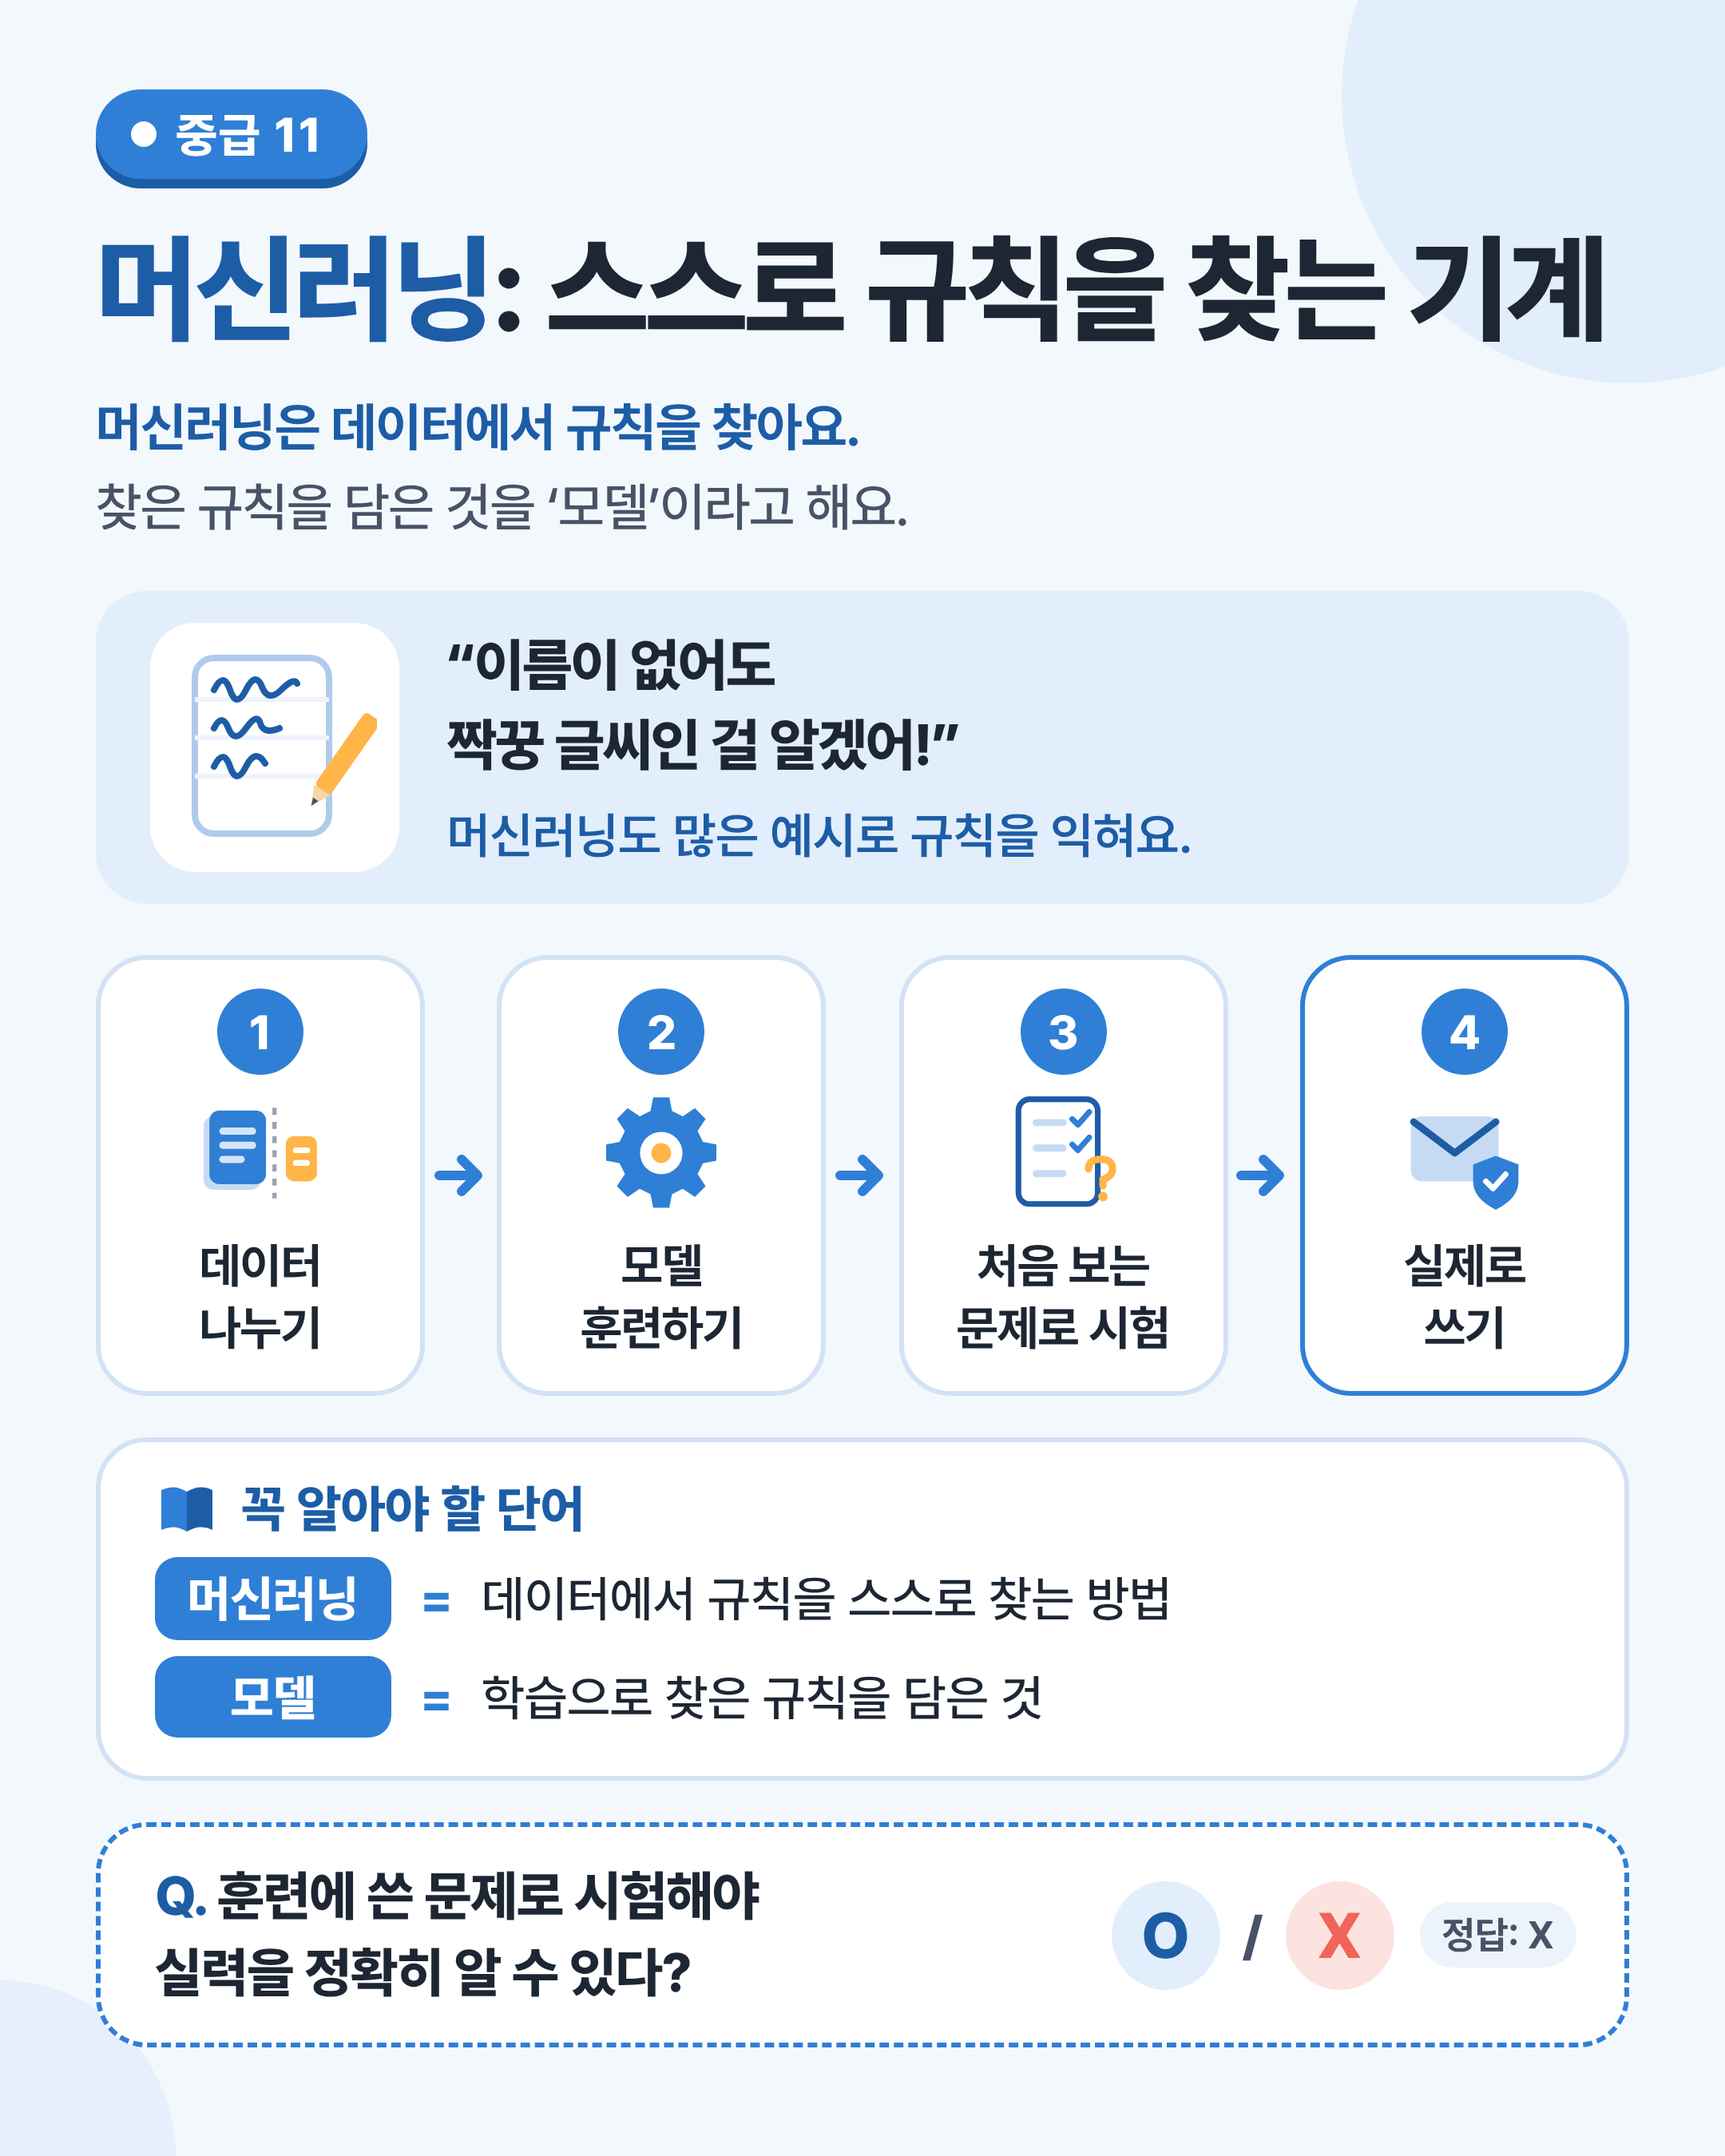
그림 내용 글로 보기
중급 11
머신러닝: 스스로 규칙을 찾는 기계
머신러닝은 데이터에서 규칙을 찾아요.찾은 규칙을 담은 것을 ‘모델’이라고 해요.
“이름이 없어도짝꿍 글씨인 걸 알겠어!”
머신러닝도 많은 예시로 규칙을 익혀요.
- 1. 데이터 나누기
- 2. 모델 훈련하기
- 3. 처음 보는 문제로 시험
- 4. 실제로 쓰기
- 머신러닝 데이터에서 규칙을 스스로 찾는 방법
- 모델 학습으로 찾은 규칙을 담은 것
Q. 훈련에 쓴 문제로 시험해야 실력을 정확히 알 수 있다?
정답: X
그림으로 보는 흐름
- 데이터 나누기
모은 데이터를 ‘훈련용’과 ‘시험용’으로 나눠요. 시험용은 훈련 때 보여 주지 않아요.
- 모델 훈련하기
훈련용 데이터로 규칙을 찾아 모델을 만들어요.
- 처음 보는 문제로 시험
한 번도 보지 않은 시험용 데이터로 얼마나 잘 맞히는지 확인해요.
- 실제로 쓰기
시험을 통과한 모델로 새 문자를 걸러요. 쓰면서도 틀린 것은 계속 살펴요.
꼭 알아야 할 단어
직접 해보기: 가짜 문자로 스팸 거르기 훈련과 시험
종이에 가짜 문자 10개를 만들어 보세요. (예: “축하합니다! 상품에 당첨되셨어요. 지금 바로 링크를 누르세요” / “내일 체육복 챙겨 와”) 실제로 받은 문자나 진짜 전화번호, 링크는 쓰지 않아요. 6개에는 ‘스팸’ 또는 ‘정상’ 표시를 붙여 친구에게 주고, 친구가 규칙을 찾게 해요. 그다음 표시가 없는 나머지 4개로 시험을 봐요. 친구가 찾은 규칙이 처음 보는 문자에도 잘 맞았나요?
- 가짜 문자 10개를 만들어요. 6개에는 ‘스팸’ 또는 ‘정상’ 표시를 붙여요.
- 표시 붙은 6개를 친구에게 주고, 친구가 규칙을 찾게 해요. (훈련)
- 표시가 없는 나머지 4개로 시험을 봐요. 친구의 답을 아래 표에 적어요. (시험)
실제로 받은 문자나 진짜 전화번호, 링크는 쓰지 않아요.
머신러닝은 훈련용 데이터로 규칙을 찾고, 처음 보는 데이터로 실력을 확인해요.
확인 퀴즈
정답과 점수는 저장하지 않습니다.
-
훈련에 쓴 문제로 시험해야 실력을 정확히 알 수 있다.
정답 보기
정답 X. 이미 본 문제는 외워서 맞힐 수 있어서, 처음 보는 데이터로 시험해야 해요.
-
‘모델’에 대한 설명으로 알맞은 것은?
- ① 학습으로 찾은 규칙을 담은 것
- ② 사진을 찍는 사람
- ③ 컴퓨터 화면의 크기
정답 보기
정답 ①. 머신러닝으로 만든 결과물을 모델이라고 해요.
중2 한 걸음 더
중2 한 걸음 더: 과적합, 그리고 AI·머신러닝·딥러닝
훈련 문제는 잘 맞히는데 새 문제에서는 자꾸 틀리는 상태를 ‘과적합(overfitting)’이라고 해요. 문제집의 답만 외운 것과 비슷하지요. 그래서 시험용 데이터를 따로 남겨 두는 거예요.
참고로 AI, 머신러닝, 딥러닝은 서로 포함 관계예요. AI가 가장 큰 범위이고, 그 안에 머신러닝이, 머신러닝 안에 여러 층의 인공 신경망을 쓰는 ‘딥러닝(deep learning)’이 있어요.
쉽게 풀어 보기
규칙을 적기 어려운 일
스팸 문자를 거르는 규칙을 사람이 다 적을 수 있을까요? “당첨”이라는 말이 있으면 스팸? 그런데 “경품 당첨 축하해!”라는 친구 문자도 있어요. 규칙은 끝없이 늘어나요.
머신러닝(machine learning)은 데이터에서 규칙을 스스로 찾는 방법이에요. ‘스팸’, ‘정상’ 표시가 붙은 문자를 아주 많이 보여 주면, 컴퓨터가 어떤 문자가 스팸에 가까운지 규칙을 찾아요.
이렇게 학습으로 찾은 규칙을 담은 것을 모델(model)이라고 해요. 모델은 새 문자가 오면 스팸일 가능성을 계산해 줘요.
짝꿍 글씨체 알아보기로 이해해요
짝꿍 공책에 이름이 없어도 글씨만 보고 “이건 짝꿍 글씨야!” 하고 알아본 적 있지요? 그런데 어떻게 아는지 규칙으로 설명해 보라고 하면 어려워요. 글씨를 많이 보면서 저절로 익혔기 때문이에요.
머신러닝도 비슷해요. 스팸 문자를 거르는 규칙을 사람이 다 적기는 어렵지만, ‘스팸’과 ‘정상’ 표시가 붙은 문자를 아주 많이 보여 주면 컴퓨터가 스스로 규칙을 찾아요.
실력은 처음 보는 문제로 확인해요
모델의 실력을 확인할 때는 훈련 때 보여 주지 않은 데이터로 시험해요. 이 데이터를 시험용 데이터(test data)라고 해요.
훈련에 쓴 문제로 시험하면, 모델이 규칙을 찾은 게 아니라 답을 외워서 맞힐 수도 있어요. 문제집 답을 외운 학생이 같은 문제는 다 맞히는 것처럼요.
생활 속 머신러닝은 많아요. 메일함의 스팸 거르기, 은행의 이상한 결제 알림, 사진 앱의 얼굴 묶기가 그 예예요. 모두 데이터로 훈련하고, 처음 보는 데이터로 확인한 뒤 쓰여요. 쓰는 동안에도 틀릴 수 있어서 사람이 계속 살펴요.
뒤에 나오는 ‘직접 해보기 미션’에서 가짜 문자로 훈련과 시험을 직접 해 봐요.
숫자로 보기
- 예시 6 : 4 미션에서 가짜 문자 10개를 훈련용 6개, 시험용 4개로 나눠요.
- 예시 4단계 데이터 나누기 → 모델 훈련 → 처음 보는 문제로 시험 → 실제로 쓰기
- 사실 1959년 아서 새뮤얼이 ‘머신러닝’이라는 말을 쓴 논문을 발표했어요.
표로 정리해요
| 단계 | 하는 일 | 스팸 문자 예시 |
|---|---|---|
| 데이터 나누기 | 모은 데이터를 ‘훈련용’과 ‘시험용’으로 나눠요. 시험용은 훈련 때 보여 주지 않아요. | 표시 붙은 문자 1,000개를 800개, 200개로 나눠요. |
| 모델 훈련하기 | 훈련용 데이터로 규칙을 찾아 모델을 만들어요. | 스팸에 자주 나오는 말, 링크 같은 특징을 찾아요. |
| 처음 보는 문제로 시험 | 한 번도 보지 않은 시험용 데이터로 얼마나 잘 맞히는지 확인해요. | 남겨 둔 200개로 맞히는 비율을 재요. |
| 실제로 쓰기 | 시험을 통과한 모델로 새 문자를 걸러요. 쓰면서도 틀린 것은 계속 살펴요. | 잘못 걸러진 문자는 다시 확인해요. |
| 비교해 봐요 | 훈련용 데이터 | 시험용 데이터 |
|---|---|---|
| 쓰임 | 규칙을 찾는 데 써요. | 실력을 확인하는 데 써요. |
| 보여 주나요? | 훈련 때 보여 줘요. | 훈련 때 보여 주지 않아요. |
| 문제집에 비유하면 | 연습 문제 | 처음 보는 시험 문제 |
그래프로 보기
맞히는 비율 (%) · 모델과 데이터
※ 이해를 도우려고 만든 예시 숫자예요. 모델 A는 훈련 문제만 잘 맞히는 과적합의 모습이에요.
용어 정리
| 용어 | 영어 | 뜻 | 예 |
|---|---|---|---|
| 머신러닝 | machine learning | 데이터에서 규칙을 스스로 찾는 방법 | 스팸 거르기 |
| 모델 | model | 학습으로 찾은 규칙을 담은 것 | 스팸 판별 모델 |
| 훈련용 데이터 | training data | 규칙을 찾는 데 쓰는 데이터 | 표시 붙은 문자 6개 |
| 시험용 데이터 | test data | 실력 확인용으로 남겨 둔 데이터 | 표시 없는 문자 4개 |
| 훈련 | training | 데이터로 모델의 규칙을 찾는 과정 | 스팸 특징 익히기 |
| 스팸 | spam | 원하지 않는데 마구 보내지는 광고·사기 메시지 | “당첨! 링크를 누르세요” |
| 정확도 | accuracy | 전체 가운데 맞힌 비율 | 200개 중 180개 → 90% |
| 과적합 | overfitting | 훈련 문제만 잘 맞히고 새 문제는 틀리는 상태 | 답만 외운 공부 |
| 딥러닝 | deep learning | 여러 층의 인공 신경망을 쓰는 머신러닝 | 사진·음성 인식 |
| 특징 | feature | 구별에 도움이 되는 성질 | 링크, “당첨” 같은 말 |
활동지 문제
활동지 문제
-
훈련 문제는 잘 맞히는데 새 문제에서는 자꾸 틀리는 상태를 ( )(이)라고 해요.
정답 보기
정답 과적합(overfitting) . 문제집 답만 외운 것과 비슷해요.
-
스팸 거르기 모델을 쓰는 동안에도 사람이 계속 살펴야 하는 까닭을 써 보세요.
정답 보기
정답 (예시 답) 모델도 틀릴 수 있어서 중요한 문자가 스팸으로 걸러지거나, 새로운 수법의 스팸을 놓칠 수 있기 때문이에요.
교사용 박스
수업에서 바로 쓰는 지도 팁입니다.
수업 흐름(40분)
| 구간 | 시간 | 활동 |
|---|---|---|
| 도입 | 5분 | 짝꿍 글씨를 이름 없이도 알아본 경험을 묻고, 그 규칙을 말로 설명할 수 있는지 물어봅니다. |
| 개념 | 12분 | 데이터 나누기 → 모델 훈련 → 처음 보는 문제로 시험 → 실제로 쓰기의 흐름을 설명하고, 훈련용과 시험용을 나누는 까닭을 강조합니다. |
| 활동 | 18분 | 가짜 문자 10개 만들기 미션을 합니다. 6개에만 ‘스팸/정상’ 표시를 붙여 친구가 규칙을 찾게 하고, 나머지 4개로 시험합니다. |
| 정리 | 5분 | 친구의 규칙이 처음 보는 문자에도 맞았는지 확인하고 퀴즈를 풉니다. |
도입 질문
- 스팸 문자를 거르는 규칙을 사람이 모두 적을 수 있을까요?
- 시험 문제를 미리 보고 공부하면 진짜 실력을 알 수 있을까요?
자주 하는 오개념
-
오개념. 훈련에 쓴 문제로 시험해도 실력을 알 수 있다.
바로잡기. 이미 본 문제는 외워서 맞힐 수 있다는 점을 문제집 답 외우기 예로 설명하고, 시험용 데이터를 따로 두는 까닭을 짚습니다.
-
오개념. 모델은 사진이나 모형 같은 물건이다.
바로잡기. 모델은 “학습으로 찾은 규칙을 담은 것”이라고 정의하고, 활동에서 친구가 찾은 규칙 목록이 곧 모델에 해당한다고 연결합니다.
활동 준비물
- 문자 카드용 종이(1인당 10장)
- ‘스팸/정상’ 스티커
- 활동지
안전 유의점
- 실제로 받은 문자, 진짜 전화번호, 링크는 쓰지 않고 지어낸 문장만 씁니다.
평가 포인트
- 훈련용과 시험용 데이터를 나누는 까닭을 설명할 수 있는가
- 모델의 뜻을 말할 수 있는가
초6·중2 차이를 두는 법
초6
문자 카드 수를 6개(표시 4개, 시험 2개)로 줄여 진행합니다.
중2
과적합의 뜻과 AI ⊃ 머신러닝 ⊃ 딥러닝 포함 관계를 그림으로 정리합니다.