한 줄 요약
AI는 배운 데이터를 닮아요. 데이터가 한쪽으로 치우치거나 과거의 차별이 담겨 있으면, AI도 어떤 사람이나 대상에게 불공평한 판단을 할 수 있어요. 이것을 AI 편향(bias)이라고 해요.
학습 목표
- AI 편향이 생기는 까닭(치우친 데이터, 과거의 차별)을 설명할 수 있어요.
- 편향, 공정성, 대표성의 뜻을 말할 수 있어요.
- AI 편향을 줄이는 방법을 제안할 수 있어요.
생활 속 비유: 날아다니는 새 사진만 본 AI
‘새’를 가르치려고 하늘을 나는 참새, 비둘기, 까치 사진만 잔뜩 보여 줬다고 해 봐요. 이 AI에게 펭귄이나 타조 사진을 보여 주면 “새가 아니에요”라고 할 수 있어요. AI가 나빠서가 아니라, ‘새는 하늘을 난다’는 치우친 데이터로 배웠기 때문이에요. 사람을 판단하는 일에서 이런 치우침이 생기면 훨씬 심각한 문제가 돼요.
인포그래픽
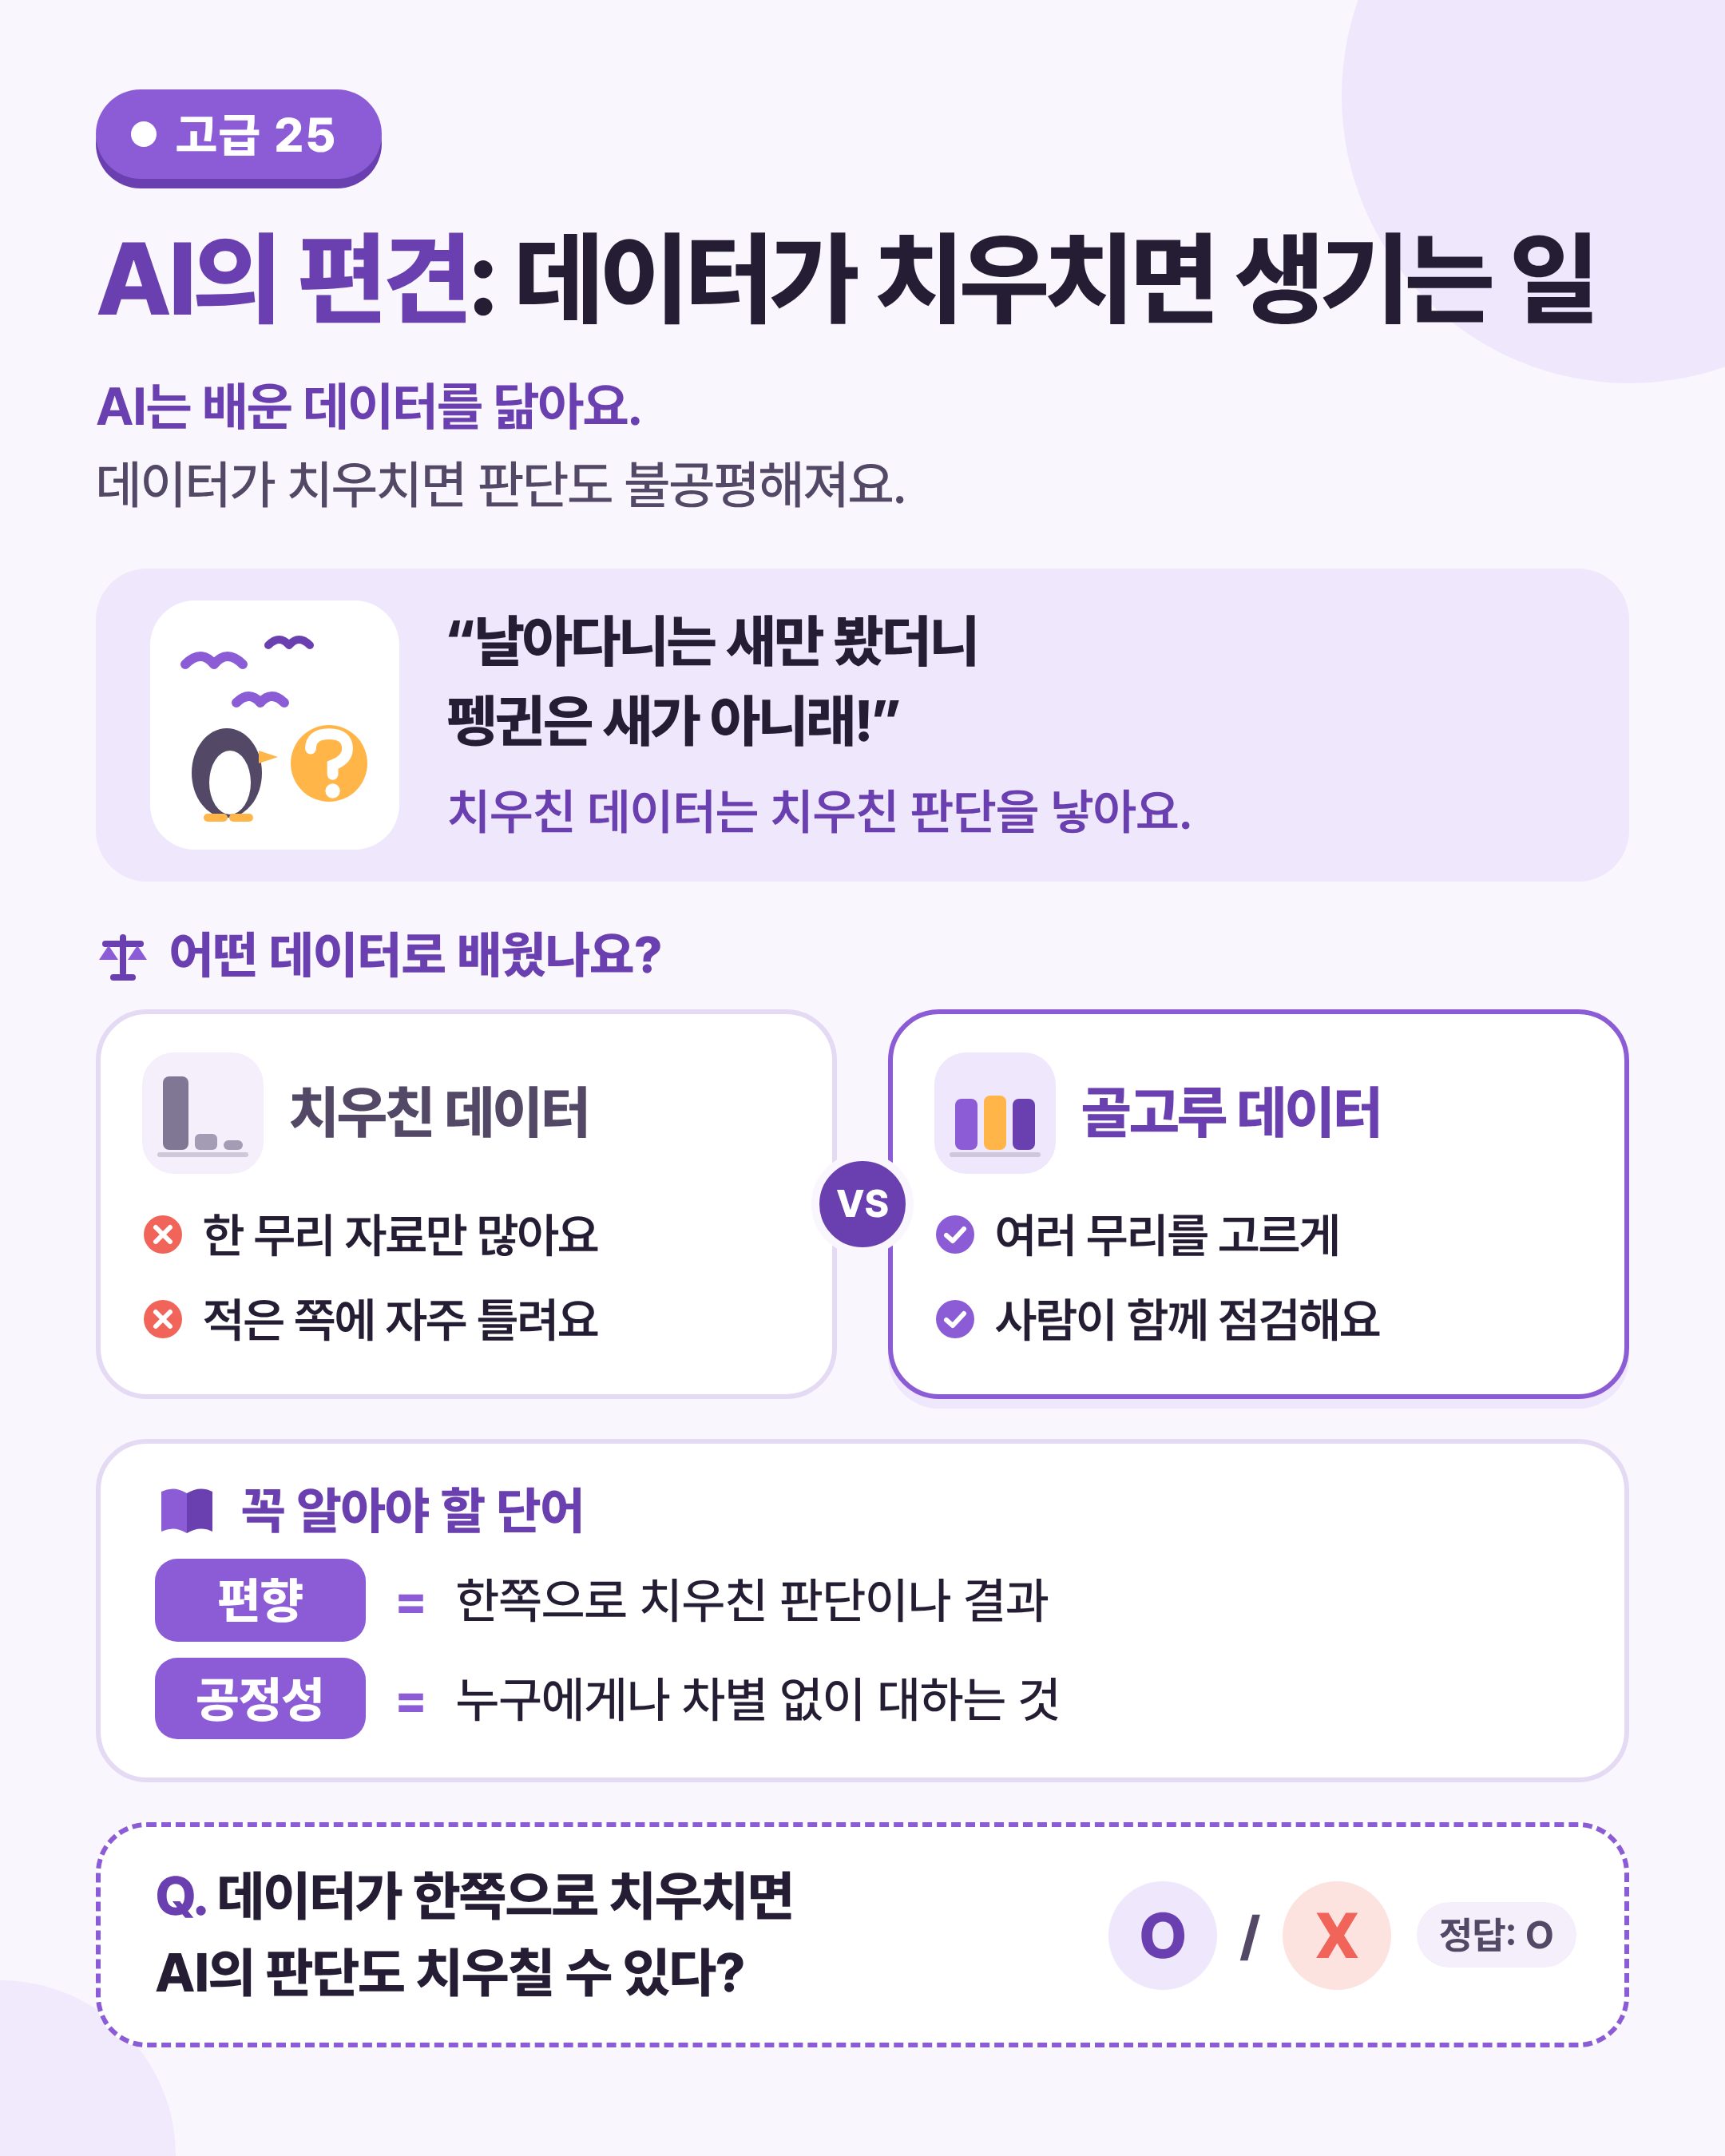
그림 내용 글로 보기
고급 25
AI의 편견: 데이터가 치우치면 생기는 일
AI는 배운 데이터를 닮아요.데이터가 치우치면 판단도 불공평해져요.
“날아다니는 새만 봤더니펭귄은 새가 아니래!”
치우친 데이터는 치우친 판단을 낳아요.
- 어떤 데이터로 배웠나요?
- 치우친 데이터
- 한 무리 자료만 많아요
- 적은 쪽에 자주 틀려요
- 골고루 데이터
- 여러 무리를 고르게
- 사람이 함께 점검해요
- 편향 한쪽으로 치우친 판단이나 결과
- 공정성 누구에게나 차별 없이 대하는 것
Q. 데이터가 한쪽으로 치우치면 AI의 판단도 치우칠 수 있다?
정답: O
그림으로 보는 비교
- 치우친 데이터
어떤 무리의 자료만 많아요. → 자료가 적은 무리에게 자주 틀리거나 불리하게 판단해요.
- 골고루 데이터
여러 무리의 자료를 고르게 모아요. → 더 많은 사람에게 공정하게 작동할 가능성이 커져요. 그래도 사람이 결과를 함께 점검해요.
꼭 알아야 할 단어
직접 해보기: 우리 반 ‘과일’ 데이터 살펴보기
반 친구들에게 ‘과일’ 하면 떠오르는 것을 하나씩 적어 달라고 한 뒤 표로 정리해요. 이름은 적지 않고 답만 모아요. 아마 사과, 바나나, 딸기가 많고 용과나 두리안은 거의 없을 거예요. 이 표로만 배운 AI라면 용과 사진을 보고 과일이라고 알아볼까요? 마지막으로 데이터를 골고루 만들려면 무엇을 더 모아야 할지 목록을 만들어 봐요.
- 친구들의 답을 모아 많이 나온 순서대로 표에 적어요. 이름은 적지 않고 답만 모아요.
- 이 표로만 배운 AI라면 용과 사진을 보고 과일이라고 알아볼지 생각해요.
- 데이터를 골고루 만들려면 무엇을 더 모아야 할지 목록을 만들어요.
친구의 답을 놀리지 않아요. 적게 나온 답일수록 데이터를 골고루 만드는 데 소중해요.
AI는 배운 데이터를 닮아요. 골고루 모으고, 무리별로 점검해야 공정해져요.
확인 퀴즈
정답과 점수는 저장하지 않습니다.
-
데이터가 한쪽으로 치우치면 AI의 판단도 치우칠 수 있다.
정답 보기
정답 O. AI는 배운 데이터의 모습을 그대로 닮기 쉬워요.
-
AI 편향을 줄이는 방법으로 알맞지 않은 것은?
- ① 여러 무리의 데이터를 고르게 모으기
- ② 사람이 결과를 점검하기
- ③ 이미 많은 무리의 데이터만 더 모으기
정답 보기
정답 ③. 치우침이 더 커질 수 있어요.
중2 한 걸음 더
중2 한 걸음 더: 실제로 드러난 AI 편향
실제로 한 해외 기업이 이력서를 평가하는 AI를 시험 삼아 만들었다가, 과거 지원자 자료에 남성이 훨씬 많았던 탓에 여성 지원자에게 불리하게 점수를 매기는 문제가 드러나 쓰지 않기로 했다는 보도가 있었어요. 얼굴 인식 기술의 정확도가 피부색이나 성별에 따라 다르다는 연구도 있었어요.
그래서 개발자는 데이터를 다양하게 모으고, 무리별로 결과를 따로 확인하고, 중요한 결정은 사람이 최종 검토해야 해요. ‘완벽하게 공정한 AI’는 만들기 어려워서 꾸준히 점검하고 고쳐야 해요.
쉽게 풀어 보기
AI는 데이터를 닮아요
AI는 데이터에서 규칙을 찾아요. 그래서 데이터가 한쪽으로 치우치면 AI의 판단도 치우쳐요. 한쪽으로 치우친 판단이나 결과를 편향(bias)이라고 해요.
데이터가 실제 세상을 고르게 담고 있는 정도를 대표성(representativeness)이라고 해요. 대표성이 낮으면, 자료가 적은 무리에게 AI가 자주 틀리거나 불리하게 판단해요.
누구에게나 고르게, 차별 없이 대하는 것을 공정성(fairness)이라고 해요. AI를 만들고 쓰는 사람은 공정성을 꾸준히 점검해야 해요.
날아다니는 새 사진만 본 AI로 이해해요
‘새’를 가르치려고 하늘을 나는 참새, 비둘기, 까치 사진만 잔뜩 보여 줬다고 해 봐요. 이 AI에게 펭귄이나 타조 사진을 보여 주면 “새가 아니에요”라고 할 수 있어요.
AI가 나빠서가 아니라, ‘새는 하늘을 난다’는 치우친 데이터로 배웠기 때문이에요.
사람을 판단하는 일에서 이런 치우침이 생기면 훨씬 심각한 문제가 돼요.
생활 속 편향, 사람에게 생기면
입학, 채용, 대출처럼 사람의 기회를 정하는 일에 AI를 쓴다고 생각해 봐요. 과거 기록에 차별이 담겨 있었다면, AI는 그 차별을 규칙처럼 배워 되풀이할 수 있어요.
얼굴 인식, 음성 인식도 마찬가지예요. 어떤 무리의 데이터가 적으면 그 무리에서 더 자주 틀릴 수 있어요.
그래서 데이터를 고르게 모으고, 무리별로 결과를 따로 확인하고, 중요한 결정은 사람이 최종 검토해요. 완벽하게 공정한 AI는 만들기 어려워서 꾸준히 점검하고 고쳐야 해요.
뒤에 나오는 ‘직접 해보기 미션’에서 우리 반 ‘과일’ 데이터의 치우침을 직접 확인해 봐요.
숫자로 보기
- 사실 2018년 해외 기업의 이력서 평가 AI가 여성 지원자에게 불리했다는 보도가 나왔어요.
- 예시 3가지 이 강의 핵심 단어: 편향, 공정성, 대표성
- 예시 25명 중 0명 미션에서 ‘용과’를 떠올린 친구 수를 예로 든 숫자예요.
표로 정리해요
| 데이터 | 어떤 결과가 생길까요? |
|---|---|
| 치우친 데이터 | 어떤 무리의 자료만 많아요. → 자료가 적은 무리에게 자주 틀리거나 불리하게 판단해요. |
| 골고루 데이터 | 여러 무리의 자료를 고르게 모아요. → 더 많은 사람에게 공정하게 작동할 가능성이 커져요. 그래도 사람이 결과를 함께 점검해요. |
| 생기는 곳 | 이런 일이 생겨요 | 이렇게 줄여요 |
|---|---|---|
| 데이터 모으기 | 어떤 무리의 자료가 적어요. | 여러 무리의 데이터를 고르게 모아요. |
| 과거 기록 | 예전의 차별이 기록에 남아 있어요. | 기록을 살펴 차별이 담긴 기준을 빼요. |
| 결과 확인 | 평균만 보면 문제가 숨어요. | 무리별로 결과를 따로 확인해요. |
| 결정 | AI 판단을 그대로 써요. | 중요한 결정은 사람이 최종 검토해요. |
그래프로 보기
‘새’라고 맞힌 비율 (%) · 새의 무리
※ 이해를 도우려고 만든 예시 숫자예요. 무리별로 따로 보면 숨은 치우침이 드러나요.
용어 정리
| 용어 | 영어 | 뜻 | 예 |
|---|---|---|---|
| 편향 | bias | 한쪽으로 치우친 판단이나 결과 | 나는 새만 새라고 함 |
| 공정성 | fairness | 누구에게나 고르게, 차별 없이 대하기 | 모든 무리에서 비슷한 정답률 |
| 대표성 | representativeness | 데이터가 세상을 고르게 담은 정도 | 여러 종류의 새 사진 |
| 차별 | discrimination | 정당한 까닭 없이 다르게 대하기 | 성별로 점수 깎기 |
| 무리 | group | 공통점으로 묶인 집단 | 헤엄치는 새 |
| 정답률 | accuracy | 맞힌 비율 | 95%, 30% |
| 최종 검토 | final review | 마지막에 사람이 살펴보고 결정하기 | 채용 결정 |
| 이력서 | résumé | 학력과 경력을 적은 문서 | 지원자 서류 |
| 과거 기록 | historical data | 예전에 쌓인 자료 | 예전 지원자 자료 |
| 점검 | audit | 문제가 없는지 꼼꼼히 살피기 | 무리별 결과 확인 |
활동지 문제
활동지 문제
-
데이터가 실제 세상을 고르게 담고 있는 정도를 ( )(이)라고 해요.
정답 보기
정답 대표성(representativeness) . 대표성이 낮으면 편향이 생기기 쉬워요.
-
무리별로 결과를 따로 확인해야 하는 까닭을 써 보세요.
정답 보기
정답 (예시 답) 전체 평균이 높아도 자료가 적은 무리에서는 자주 틀릴 수 있어서, 따로 봐야 숨은 불공정이 드러나기 때문이에요.
교사용 박스
수업에서 바로 쓰는 지도 팁입니다.
수업 흐름(40분)
| 구간 | 시간 | 활동 |
|---|---|---|
| 도입 | 5분 | 날아다니는 새 사진만 본 AI에게 펭귄을 보여 주면 어떻게 답할지 묻습니다. |
| 개념 | 10분 | 치우친 데이터와 골고루 데이터를 비교 카드로 설명하고, 편향·공정성·대표성의 뜻을 정리합니다. |
| 활동 | 20분 | 반 친구들이 ‘과일’ 하면 떠오르는 것을 이름 없이 적어 표로 정리하고, 이 표로만 배운 AI가 용과를 알아볼지 이야기합니다. 데이터를 골고루 만들 목록을 모둠별로 씁니다. |
| 정리 | 5분 | 편향을 줄이는 방법을 정리하고 퀴즈를 풉니다. |
도입 질문
- AI가 불공평한 판단을 한다면 그것은 AI가 나빠서일까요?
- 우리 반 과일 표는 세상의 과일을 고르게 담고 있을까요?
자주 하는 오개념
-
오개념. AI는 기계라서 늘 공정하다.
바로잡기. AI는 배운 데이터를 닮는다는 점을 과일 표 활동 결과로 확인합니다.
-
오개념. 이미 많은 데이터를 더 모으면 편향이 줄어든다.
바로잡기. 퀴즈 2번처럼 한쪽 데이터만 늘리면 치우침이 더 커질 수 있다고 설명합니다.
-
오개념. 편향은 한 번 고치면 끝난다.
바로잡기. 무리별 결과 확인과 사람의 최종 검토를 꾸준히 해야 한다는 점을 짚습니다.
활동 준비물
- 집계표
- 활동지(데이터 보충 목록)
안전 유의점
- 사람을 무리로 나누어 비교하는 예를 들 때 반 친구의 특징을 소재로 삼지 않습니다.
평가 포인트
- 편향·공정성·대표성의 뜻을 말할 수 있는가
- 치우친 데이터가 판단에 미치는 영향을 예로 설명할 수 있는가
- 편향을 줄이는 방법을 2가지 이상 제안할 수 있는가
초6·중2 차이를 두는 법
초6
새·과일 예시처럼 사물 중심으로 다룹니다.
중2
이력서 평가 AI 보도 사례와 얼굴 인식 정확도 연구를 소개하고, 개발자가 할 일을 토의합니다.